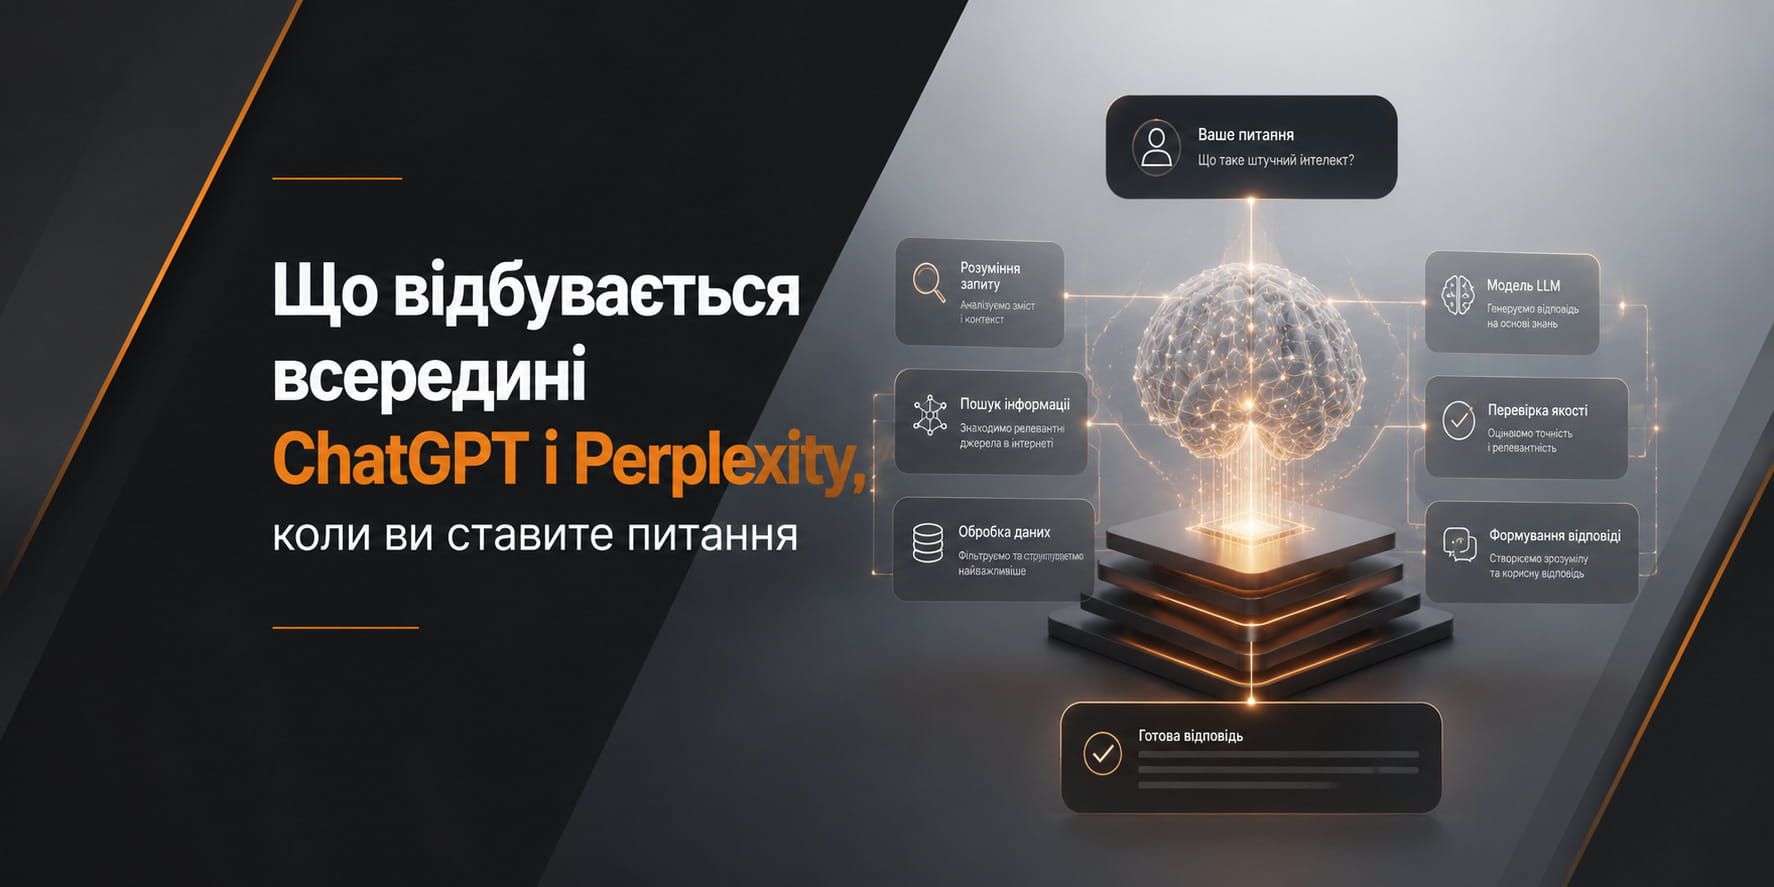
Генеративний пошук: як він працює
У статті “Що таке GEO” ми показали механіку в чотири кроки — для загального розуміння цього достатньо. Тут копаємо глибше: чому одна система шукає в реальному часі, інша відповідає з памʼяті, а третя робить і те, і те одночасно. І прослідкуємо конкретний запит від початку до кінця.
Три архітектури генеративного пошуку
“Генеративний пошук” — узагальнена назва для систем, які влаштовані принципово по-різному.
Retrieval-Augmented Generation
Система спершу шукає актуальні джерела в інтернеті чи власному індексі, а потім генерує відповідь на їх основі. Дані завжди свіжі.
Google SGE, PerplexityВідповідь із “замороженої” памʼяті
Модель відповідає на основі того, що завчила під час навчання — без живого пошуку. Дані обмежені датою навчального зрізу.
Базовий ChatGPT без пошукуПамʼять + живий пошук за потреби
Модель вирішує сама: якщо запит вимагає свіжих даних — вмикає пошук, якщо ні — відповідає з памʼяті.
ChatGPT з увімкненим пошукомЦе пояснює, чому та сама модель може дати різні відповіді на схожі запити: один спрацював за памʼяттю, інший запустив живий пошук в інтернеті.
Що таке embeddings простими словами
В основі пошуку джерел у RAG-системах лежить не звичний пошук за ключовими словами, а векторний пошук за змістом. Кожен фрагмент тексту перетворюється на набір чисел — embedding, — який відображає його зміст у багатовимірному просторі.
Уявіть величезну кімнату, де тексти зі схожим змістом стоять близько одне до одного, а зовсім різні за темою — далеко. Коли ви ставите запит, система теж перетворює його на точку в цій кімнаті й шукає найближчих “сусідів” — фрагменти тексту з найближчим змістом, навіть якщо в них немає жодного спільного слова із запитом.
Саме тому текст може потрапити у відповідь, навіть якщо в ньому немає точного ключового слова із запиту, — має значення змістова близькість, а не збіг слів. І навпаки: текст із правильними ключовими словами, але розмитим змістом, може програти чіткішому за формулюванням конкуренту.
Простежимо один запит
Візьмемо реалістичний приклад: користувач питає в Perplexity, який безкоштовний інструмент перевірити зворотні посилання власного сайту.
Чому не кожне джерело потрапляє у відповідь
З прикладу вище видно вузьке місце: із 20–30 знайдених сторінок у фінальну відповідь потрапляють одиниці. Причин відсіву кілька:
- Обмежений контекст. Модель фізично не може “прочитати” всі 30 сторінок одразу — є ліміт на обсяг тексту, який вона обробляє за раз.
- Дублювання інформації. Якщо пʼять сторінок кажуть те саме, система обирає одну-дві найавторитетніші, а решту відкидає як надлишкові.
- Розмитість фрагмента. Сторінка може бути релевантною загалом, але якщо потрібна відповідь “розмазана” по всьому тексту без чіткого фрагмента — її важче витягнути й процитувати.
Що це означає для власників сайтів
Розуміння механіки прямо підказує практичні кроки. По-перше, тексти варто ділити на самодостатні фрагменти — кожен підрозділ повинен мати сенс навіть вирваний з контексту, бо саме так система його й “вириває”. По-друге, не варто розмазувати одну відповідь по всій статті: якщо є пряме питання, дайте на нього пряму відповідь в одному місці, а не частинами в різних абзацах. По-третє, змістова точність важливіша за формальний збіг ключових слів — векторний пошук працює зі смислом, а не з буквальним текстом.
Часті запитання
Чи можна дізнатись, скільки джерел система розглянула перед відповіддю?
Ні, це внутрішній процес, недоступний користувачеві напряму. Perplexity показує список використаних джерел у відповіді, але не тих, що були розглянуті й відкинуті.
Чому ChatGPT іноді відповідає застарілими даними?
Якщо модель відповідає з “замороженої” памʼяті без увімкненого пошуку, вона не знає нічого, що сталося після дати навчального зрізу. Для свіжих даних потрібно явно ввімкнути режим пошуку.
Чи впливає довжина статті на шанс потрапити у відповідь?
Напряму — ні. Важливіша чіткість конкретного фрагмента, а не загальний обсяг тексту. Коротка стаття з точною прямою відповіддю має не менше шансів, ніж довгий матеріал із розмитими формулюваннями.